Je Eigen Rapporten en JSON
De process context graph is een standaard: wij bepalen wat erin gaat, dus jij hoeft niets te doen om het te krijgen. Alles ernaast is van jou. Een project kan een willekeurig aantal rapporten bevatten, elk met een willekeurig aantal JSON-bestanden, met namen en vormen die jij kiest - en je agent bereikt ze precies zoals hij de standaard grafiek bereikt.
Er zijn twee manieren om er een te maken:
- Met een script. Jij, of je eigen agent, schrijft een kort Python-script dat de log in het project leest en een rapport schrijft. Er komt geen AI aan te pas.
- In gewone taal. Beschrijf het rapport in je eigen woorden, noem de JSON-bestanden die je wilt, en de AI schrijft het rapport en de bestanden.
In beide gevallen is het resultaat hetzelfde: een gepubliceerd rapport op het scherm Rapporten, met JSON-bestanden met jouw eigen namen, naast de standaard grafiek en niet erin. Beide onderstaande voorbeelden zijn uitgevoerd op hetzelfde echte purchase-to-pay project, met 1,6 miljoen gebeurtenissen, en de getoonde bestanden zijn die welke ze produceerden. Hoe je agent zijn tool en sleutel krijgt staat op Connect Your Own Agent.
De ene regel: geef je JSON een eigen naam
Een JSON-bestand dat "schema": "mindzie.process-context-graph" zegt wordt gehouden aan onze definitie wanneer het rapport wordt gepubliceerd, en een bestand dat niet de vorm heeft stopt het publiceren van het rapport. Een bestand met elke andere schemanaam, of geen, wordt nooit aan de onze getoetst - de vorm is wat jij bepaalt.
Dus een uitbreiding leent onze naam niet, en voegt geen velden toe aan de standaard grafiek. Zet wat je toevoegt in een eigen bestand, onder een eigen naam - in het onderstaande voorbeeld partner.invoice-timing - en verwijs, waar het helpt, naar de ids van de standaard grafiek (act:clear-invoice, de id van een rand, de id van een beslissing) zodat beide samenkomen.
Met een script
De vraag: komt bij de artikelcategorie "3-way match, invoice before GR" de factuur echt vóór de goederenontvangst? Dit script bevraagt de log, en schrijft een rapport met twee JSON-bestanden met eigen namen. mzreport.json_download_link(name, document) schrijft de link waar een JSON-bestand in gaat - elk naam, elke JSON, zoveel bestanden als het rapport nodig heeft.
"""Invoice timing against the goods receipt - our own report, carrying our own JSON files."""
import sys
from pathlib import Path

import mindzie_engine as me
import mzreport
from mzlog import open_project
from mzreport import write_report

# A job run passes the path it wants as sys.argv[1]; mz run passes nothing.
OUT = Path(sys.argv[1]) if len(sys.argv) > 1 else Path("preview.html")
print("writing report to %s" % OUT)

SQL = """
WITH per_case AS (
    SELECT case_id,
           min(CASE WHEN activity = 'Record Goods Receipt' THEN timestamp END) AS goods_receipt,
           min(CASE WHEN activity = 'Record Invoice Receipt' THEN timestamp END) AS invoice,
           max("Item Category") AS category
    FROM events GROUP BY case_id)
SELECT category,
       CASE WHEN goods_receipt IS NULL OR invoice IS NULL THEN 'not both recorded'
            WHEN invoice < goods_receipt THEN 'invoice before goods receipt'
            ELSE 'invoice after goods receipt' END AS timing,
       count(*) AS cases,
       round(median(date_diff('day', goods_receipt, invoice)), 1) AS median_days_receipt_to_invoice
FROM per_case GROUP BY 1, 2 ORDER BY 1, 2
"""

project = open_project()
with project.log.session() as log:
    frame = log.query(SQL)

rows = []
for record in frame.to_dict("records"):
    days = record["median_days_receipt_to_invoice"]
    rows.append({"category": record["category"], "timing": record["timing"],
                 "cases": int(record["cases"]),
                 "median_days_receipt_to_invoice": None if days != days else float(days)})

before_gr = [row for row in rows if row["category"] == "3-way match, invoice before GR"]
both = [row for row in before_gr if row["timing"] != "not both recorded"]
after_anyway = sum(row["cases"] for row in both if row["timing"] == "invoice after goods receipt")
total_both = sum(row["cases"] for row in both)
kpis = {
    "schema": "partner.invoice-timing-kpis",
    "schema_version": "1",
    "category": "3-way match, invoice before GR",
    "cases_with_both_recorded": total_both,
    "invoice_after_goods_receipt_anyway": after_anyway,
    "share_after_anyway": round(after_anyway / total_both, 4) if total_both else None,
}

sections = [
    me.heading("Invoice timing against the goods receipt"),
    me.kpis([
        me.kpi("Cases with both recorded", "{:,}".format(total_both),
               sub="category: 3-way match, invoice before GR"),
        me.kpi("Invoice came after anyway", "{:,}".format(after_anyway),
               sub="{:.0%} of them".format(kpis["share_after_anyway"] or 0)),
    ]),
    me.chart_bar(frame, x="timing", y="cases",
                 title="How invoices really fall against the goods receipt"),
    me.prose("This report is our own analysis, not one of the shipped cards. It carries two "
             "JSON files of our own naming for any program to fetch: "
             + mzreport.json_download_link("invoice-timing.json",
                                           {"schema": "partner.invoice-timing",
                                            "schema_version": "1", "rows": rows})
             + " and "
             + mzreport.json_download_link("invoice-timing-kpis.json", kpis)
             + "."),
]
write_report(OUT, meta={"title": "Invoice timing against the goods receipt"}, sections=sections)
print("wrote %s" % OUT.name)
De kolomnamen in de query zijn van deze log zelf; mz log schema zegt hoe de kolommen van jouw log heten, en mz log activities hoe de stappen heten. Dan:
mz run invoice_timing.py
mz jobs create --name "Invoice timing against the goods receipt"
mz jobs put-file --slug invoice-timing-against-the-goods-receipt --name invoice_timing.py --file invoice_timing.py
mz jobs run --slug invoice-timing-against-the-goods-receipt
mz jobs status --slug invoice-timing-against-the-goods-receipt
mz jobs outputs --slug invoice-timing-against-the-goods-receipt
mz jobs publish --slug invoice-timing-against-the-goods-receipt --run-id r0001 --output invoice_timing.html --name "Invoice timing against the goods receipt"
mz runvoert het script één keer uit in het project en toont eventuele fouten volledig - zorg dat het daar eerst schoon draait. Het schrijft een preview; de jobrun telt.mz jobs createbeantwoordt de slug van de job, die de andere commando's gebruiken.mz jobs runvoert het uit als job. Het kostte minder dan 10 seconden.mz jobs outputsnoemt de run en het rapport dat hij schreef, enmz jobs publishzet dat rapport op het scherm Rapporten.
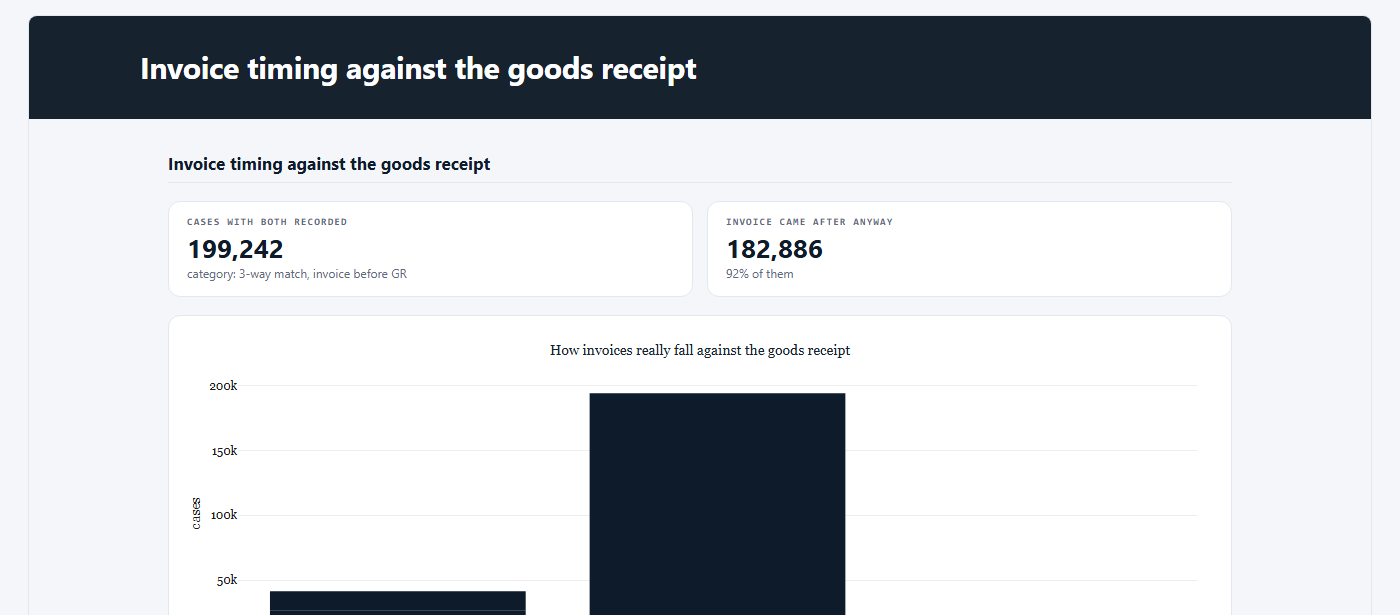
Het rapport draagt twee bestanden, en mz reports attachments --slug invoice-timing-against-the-goods-receipt lijsten ze op:
| Naam | Bytes | Schema |
|---|---|---|
invoice-timing.json |
1,254 | partner.invoice-timing 1 |
invoice-timing-kpis.json |
236 | partner.invoice-timing-kpis 1 |
mz reports attachment --slug invoice-timing-against-the-goods-receipt --name invoice-timing-kpis.json geeft het tweede bestand terug - en het antwoord op de vraag is nee: in 92 procent van die artikelen werd de factuur na de goederenontvangst geregistreerd.
{
  "schema": "partner.invoice-timing-kpis",
  "schema_version": "1",
  "category": "3-way match, invoice before GR",
  "cases_with_both_recorded": 199242,
  "invoice_after_goods_receipt_anyway": 182886,
  "share_after_anyway": 0.9179
}
In gewone woorden
Geen script: je agent beschrijft het rapport in eigen woorden en noemt de bestanden die hij wil. Dit is het briefingsbericht dat letterlijk werd gestuurd:
mz jobs create-agent --name "Payment blocks - where they are set and removed" --brief "Find where payment blocks are set and removed in this purchase-to-pay process: how many cases get a payment block, at which step it is set, how long it stays before it is removed, and which item categories and vendors are most affected. Keep it short. At the end of the report, attach two JSON files for a program to read, using mzreport.json_download_link inside a prose section: 'payment-blocks-summary.json' holding the headline numbers (cases blocked, share of all cases, median days blocked) and 'payment-blocks-by-category.json' holding one row per item category with cases blocked and median days blocked."
mz jobs run --slug payment-blocks-where-they-are-set-and-removed
mz jobs status --slug payment-blocks-where-they-are-set-and-removed
Dit is een AI-job: hij gebruikt de AI-tegoeden van je project. Het duurde 8 minuten, en het rapport publiceerde zichzelf toen de run klaar was, met precies de twee gevraagde bestanden. Een persoon kan hetzelfde rapport opvragen op het project Rapporten scherm, in het vak onder de kaarten (zie Rapporten).
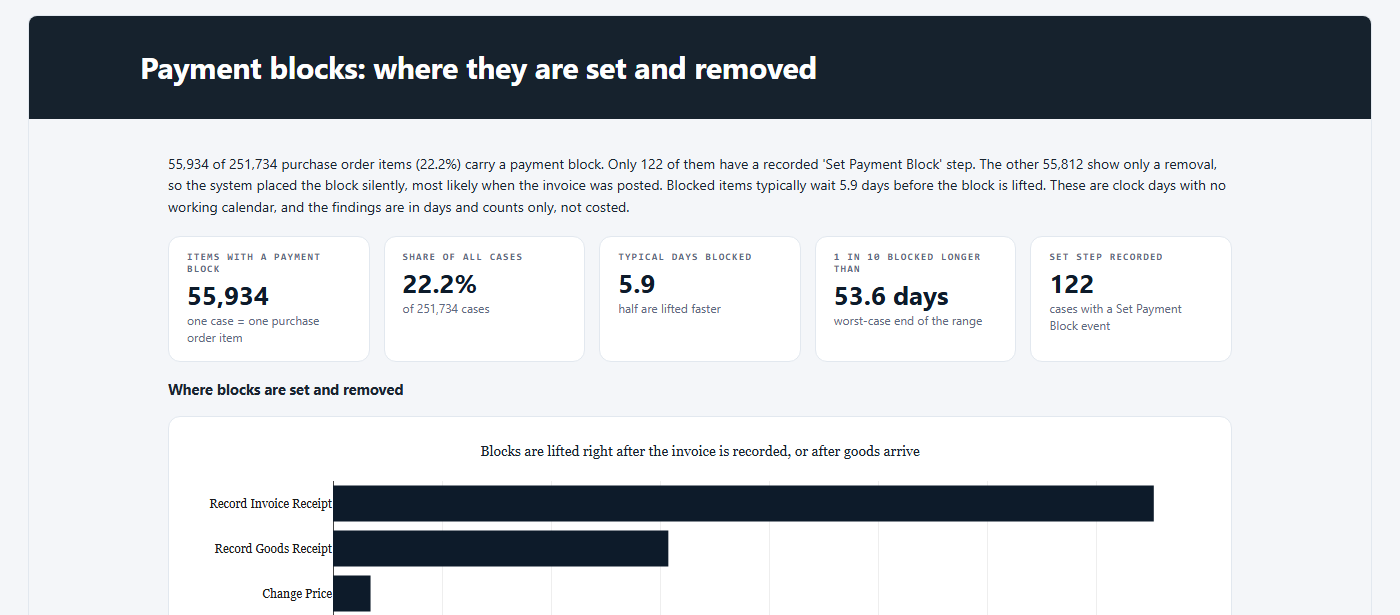
payment-blocks-summary.json, zoals mz reports attachment het teruggaf:
{
  "basis": "Cases with at least one Set Payment Block or Remove Payment Block event; one case is one purchase order item. Days are clock days.",
  "cases_total": 251734,
  "cases_blocked": 55934,
  "share_of_all_cases_percent": 22.22,
  "median_days_blocked": 5.92,
  "median_days_blocked_basis": "block start is the recorded Set Payment Block, or the last Record Invoice Receipt before the removal when no set was recorded",
  "cases_with_recorded_set": 122,
  "median_days_blocked_recorded_set_only": 15.01,
  "cases_with_recorded_set_and_removal": 13
}
De AI koos de vorm van deze bestanden, en ze benoemen geen schema. Als je programma een vaste vorm nodig heeft, beschrijf die dan in de briefing - de velden, hun namen, en een "schema"-naam van jou - of gebruik een script, waar de vorm precies is wat jij schrijft.
Je rapporten en JSON bereiken
Met dezelfde vier commando's bereik je de standaard grafiek, je eigen rapporten, en alles wat iedereen anders in het project heeft gepubliceerd:
| Commando | Wat het teruggeeft |
|---|---|
mz reports list |
Elk gepubliceerd rapport, nieuwst eerst: zijn naam, versie, wanneer en door wie gepubliceerd, en de JSON-bestanden die het draagt |
mz reports read --slug <slug> |
Eén rapport in HTML, volledig, en zijn record |
mz reports attachments --slug <slug> |
De JSON-bestanden die een rapport draagt, elk met hun grootte en het schema dat ze noemen |
mz reports attachment --slug <slug> --name <file> |
Eén JSON-bestand, als data, zonder het rapport eromheen |
De <slug> van een rapport staat in mz reports list. mz reports read, mz reports attachments en mz reports attachment nemen --version om een eerdere versie van een rapport te lezen; elke versie bewaart zijn eigen bestanden. Om een bestand op te slaan, stuur het antwoord ernaartoe: mz reports attachment --slug <slug> --name <file> > <file> (op Windows, in Command Prompt).
Een naam die het rapport niet draagt wordt geweigerd, met opgave van wat wel. Een bestand dat geen geldige JSON is wordt geweigerd in plaats van als tekst overgedragen, en de weigering zegt dat het rapport opnieuw gepubliceerd moet worden met een geldig bestand.
mz <group> --help geeft de exacte opties van elk commando.
Taken één voor één uitvoeren
Een project voert één taak tegelijk uit. Een scripttaak die start terwijl de Process Context Graph kaart draait wacht tot de kaart klaar is - bij een grote log kan dat bijna een uur zijn - en neemt dan pas zijn paar seconden.
Verder
- Connect Your Own Agent - de tool, de sleutel, en de ene zin die jouw agent verbindt.
- Het Process Context Graph krijgen - de standaard, en hoe die in één keer op te halen.
- De Cube's Toolbox - wat een script zoals hierboven kan aanroepen.