Vos propres rapports et JSON
Le graphe de contexte du processus est un élément par défaut : nous avons décidé ce qu'il contient, vous n'avez donc rien à faire pour l'obtenir. Tout ce qui va au-delà vous appartient. Un projet peut contenir un nombre quelconque de rapports, chacun contenant autant de fichiers JSON que vous voulez, avec les noms et la structure de votre choix – et votre agent y accède exactement de la même manière qu’au graphe par défaut.
Il y a deux façons d’en créer un :
- Avec un script. Vous, ou votre propre agent, écrivez un court script Python qui lit le journal dans le projet et écrit un rapport. Aucun AI n’est impliqué.
- En mots simples. Décrivez le rapport avec vos propres mots, nommez les fichiers JSON que vous souhaitez, et l’IA écrit le rapport et les fichiers.
Dans les deux cas, le résultat est le même : un rapport publié dans l’écran Rapports, contenant des fichiers JSON nommés par vos soins, à côté du graphe par défaut et non à l’intérieur. Les deux exemples ci-dessous ont été exécutés sur le même projet réel de « purchase-to-pay » de 1,6 million d’événements, et les fichiers affichés sont ceux qu’ils ont produits. La façon dont votre agent obtient son outil et sa clé est expliquée dans Connect Your Own Agent.
La règle unique : donnez à votre JSON un nom qui vous appartient
Un fichier JSON qui indique "schema": "mindzie.process-context-graph" est lié à notre définition lorsque son rapport est publié, et un fichier qui n'a pas la forme adéquate empêche la publication du rapport. Un fichier avec tout autre nom de schéma, ou aucun, n'est jamais vérifié contre le nôtre — sa forme est celle que vous décidez.
Ainsi, une extension ne doit pas emprunter notre nom, et elle n’ajoute pas de champs au graphe par défaut. Mettez ce que vous ajoutez dans un fichier à part, sous un nom qui vous appartient – l’exemple ci-dessous utilise partner.invoice-timing – et, lorsque utile, faites référence aux identifiants du graphe par défaut (act:clear-invoice, l’identité d’un lien, l'identifiant d’une décision) pour que les deux se rattachent l’un à l’autre.
Avec un script
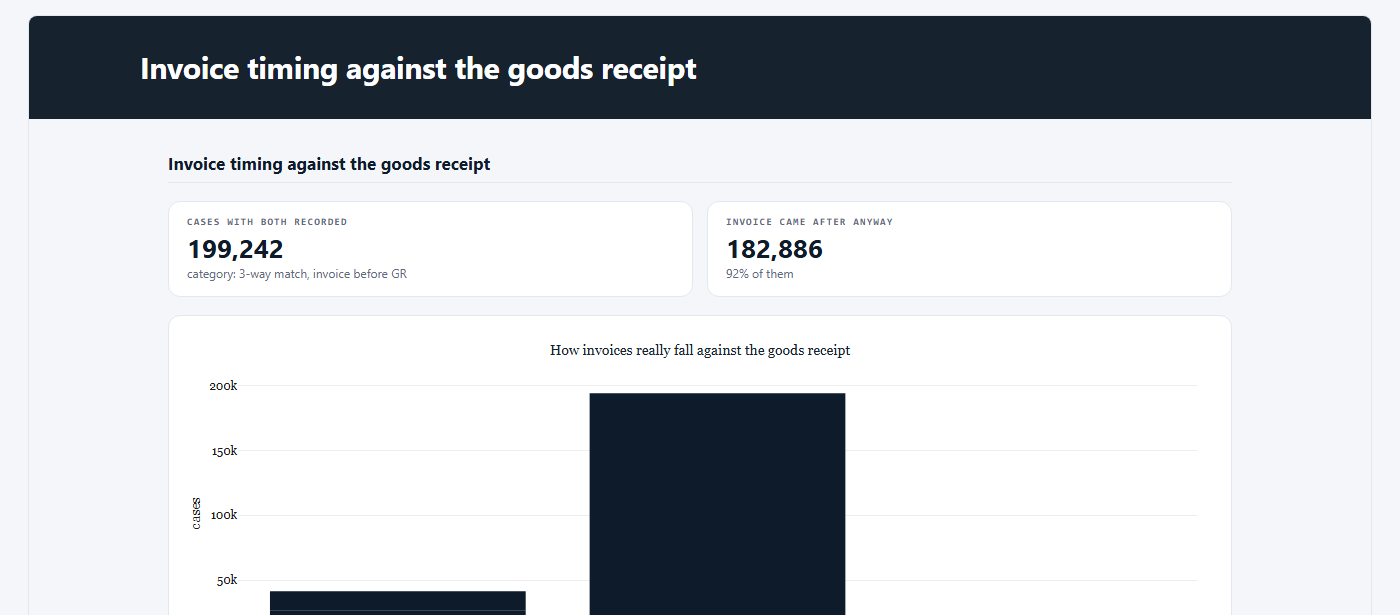
La question : dans la catégorie d’article « 3-way match, invoice before GR », est-ce que la facture arrive vraiment avant la réception des marchandises ? Ce script interroge le journal et écrit un rapport contenant deux fichiers JSON avec ses propres noms. mzreport.json_download_link(name, document) écrit le lien par lequel un fichier JSON est accessible — n'importe quel nom, n'importe quel JSON, autant de fichiers que nécessaire pour le rapport.
"""Invoice timing against the goods receipt - our own report, carrying our own JSON files."""
import sys
from pathlib import Path

import mindzie_engine as me
import mzreport
from mzlog import open_project
from mzreport import write_report

# A job run passes the path it wants as sys.argv[1]; mz run passes nothing.
OUT = Path(sys.argv[1]) if len(sys.argv) > 1 else Path("preview.html")
print("writing report to %s" % OUT)

SQL = """
WITH per_case AS (
    SELECT case_id,
           min(CASE WHEN activity = 'Record Goods Receipt' THEN timestamp END) AS goods_receipt,
           min(CASE WHEN activity = 'Record Invoice Receipt' THEN timestamp END) AS invoice,
           max("Item Category") AS category
    FROM events GROUP BY case_id)
SELECT category,
       CASE WHEN goods_receipt IS NULL OR invoice IS NULL THEN 'not both recorded'
            WHEN invoice < goods_receipt THEN 'invoice before goods receipt'
            ELSE 'invoice after goods receipt' END AS timing,
       count(*) AS cases,
       round(median(date_diff('day', goods_receipt, invoice)), 1) AS median_days_receipt_to_invoice
FROM per_case GROUP BY 1, 2 ORDER BY 1, 2
"""

project = open_project()
with project.log.session() as log:
    frame = log.query(SQL)

rows = []
for record in frame.to_dict("records"):
    days = record["median_days_receipt_to_invoice"]
    rows.append({"category": record["category"], "timing": record["timing"],
                 "cases": int(record["cases"]),
                 "median_days_receipt_to_invoice": None if days != days else float(days)})

before_gr = [row for row in rows if row["category"] == "3-way match, invoice before GR"]
both = [row for row in before_gr if row["timing"] != "not both recorded"]
after_anyway = sum(row["cases"] for row in both if row["timing"] == "invoice after goods receipt")
total_both = sum(row["cases"] for row in both)
kpis = {
    "schema": "partner.invoice-timing-kpis",
    "schema_version": "1",
    "category": "3-way match, invoice before GR",
    "cases_with_both_recorded": total_both,
    "invoice_after_goods_receipt_anyway": after_anyway,
    "share_after_anyway": round(after_anyway / total_both, 4) if total_both else None,
}

sections = [
    me.heading("Invoice timing against the goods receipt"),
    me.kpis([
        me.kpi("Cases with both recorded", "{:,}".format(total_both),
               sub="category: 3-way match, invoice before GR"),
        me.kpi("Invoice came after anyway", "{:,}".format(after_anyway),
               sub="{:.0%} of them".format(kpis["share_after_anyway"] or 0)),
    ]),
    me.chart_bar(frame, x="timing", y="cases",
                 title="How invoices really fall against the goods receipt"),
    me.prose("This report is our own analysis, not one of the shipped cards. It carries two "
             "JSON files of our own naming for any program to fetch: "
             + mzreport.json_download_link("invoice-timing.json",
                                           {"schema": "partner.invoice-timing",
                                            "schema_version": "1", "rows": rows})
             + " and "
             + mzreport.json_download_link("invoice-timing-kpis.json", kpis)
             + "."),
]
write_report(OUT, meta={"title": "Invoice timing against the goods receipt"}, sections=sections)
print("wrote %s" % OUT.name)
Les noms des colonnes dans la requête sont propres à ce journal ; mz log schema indique les noms des colonnes de votre journal, et mz log activities les noms des étapes. Ensuite :
mz run invoice_timing.py
mz jobs create --name "Invoice timing against the goods receipt"
mz jobs put-file --slug invoice-timing-against-the-goods-receipt --name invoice_timing.py --file invoice_timing.py
mz jobs run --slug invoice-timing-against-the-goods-receipt
mz jobs status --slug invoice-timing-against-the-goods-receipt
mz jobs outputs --slug invoice-timing-against-the-goods-receipt
mz jobs publish --slug invoice-timing-against-the-goods-receipt --run-id r0001 --output invoice_timing.html --name "Invoice timing against the goods receipt"
mz runexécute le script une fois dans le projet et affiche intégralement toute erreur – faites-le tourner sans erreur d’abord. Il écrit un aperçu ; c’est l’exécution du job qui compte.mz jobs createcrée le job avec son slug, que les autres commandes utilisent.mz jobs runl’exécute en tant que job. Ça a pris moins de 10 secondes.mz jobs outputsdonne les noms de l’exécution et du rapport produit, etmz jobs publishpublie ce rapport dans l’écran Rapports.
Le rapport contient deux fichiers, et mz reports attachments --slug invoice-timing-against-the-goods-receipt les liste :
| Nom | Octets | Schéma |
|---|---|---|
invoice-timing.json |
1 254 | partner.invoice-timing 1 |
invoice-timing-kpis.json |
236 | partner.invoice-timing-kpis 1 |
mz reports attachment --slug invoice-timing-against-the-goods-receipt --name invoice-timing-kpis.json renvoie le second — et la réponse à la question est non : dans 92 % de ces articles, la facture a été enregistrée après la réception des marchandises.
{
  "schema": "partner.invoice-timing-kpis",
  "schema_version": "1",
  "category": "3-way match, invoice before GR",
  "cases_with_both_recorded": 199242,
  "invoice_after_goods_receipt_anyway": 182886,
  "share_after_anyway": 0.9179
}
En mots simples
Pas de script : votre agent décrit le rapport avec ses propres mots et nomme les fichiers souhaités. Voici le brief envoyé, mot à mot :
mz jobs create-agent --name "Payment blocks - where they are set and removed" --brief "Find where payment blocks are set and removed in this purchase-to-pay process: how many cases get a payment block, at which step it is set, how long it stays before it is removed, and which item categories and vendors are most affected. Keep it short. At the end of the report, attach two JSON files for a program to read, using mzreport.json_download_link inside a prose section: 'payment-blocks-summary.json' holding the headline numbers (cases blocked, share of all cases, median days blocked) and 'payment-blocks-by-category.json' holding one row per item category with cases blocked and median days blocked."
mz jobs run --slug payment-blocks-where-they-are-set-and-removed
mz jobs status --slug payment-blocks-where-they-are-set-and-removed
C’est un job IA : il utilise les crédits IA de votre projet. Il a duré 8 minutes et le rapport s’est publié automatiquement à la fin de l’exécution, contenant exactement les deux fichiers demandés. Une personne peut demander le même rapport dans l’écran Rapports du projet, dans le cadre sous les cartes (voir Rapports).
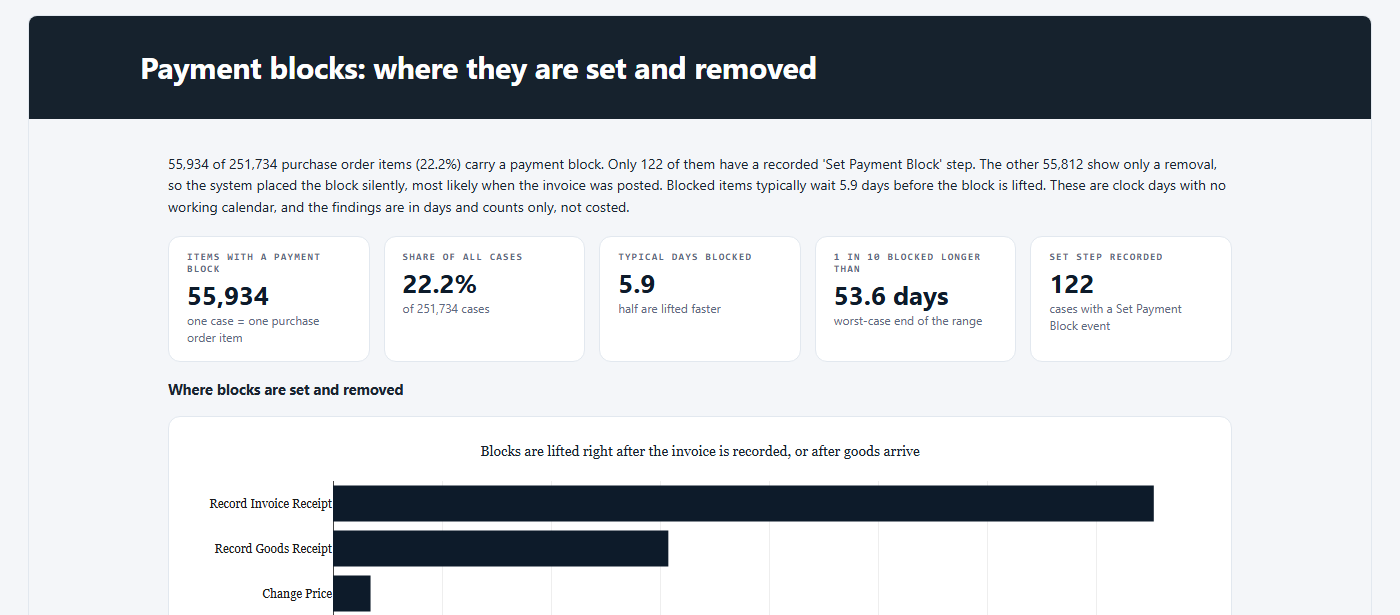
payment-blocks-summary.json, tel que renvoyé par mz reports attachment :
{
  "basis": "Cases with at least one Set Payment Block or Remove Payment Block event; one case is one purchase order item. Days are clock days.",
  "cases_total": 251734,
  "cases_blocked": 55934,
  "share_of_all_cases_percent": 22.22,
  "median_days_blocked": 5.92,
  "median_days_blocked_basis": "block start is the recorded Set Payment Block, or the last Record Invoice Receipt before the removal when no set was recorded",
  "cases_with_recorded_set": 122,
  "median_days_blocked_recorded_set_only": 15.01,
  "cases_with_recorded_set_and_removal": 13
}
L’IA a choisi la forme de ces fichiers, et ils ne nomment aucun schéma. Si votre programme a besoin d’une forme fixe, décrivez-la dans le brief – les champs, leurs noms, et un nom de "schema" personnel – ou utilisez un script, où la forme est exactement ce que vous écrivez.
Accéder à vos rapports et JSON
Les mêmes quatre commandes atteignent le graphe par défaut, vos propres rapports, et tout ce que toute personne du projet a publié :
| Commande | Ce qu’elle renvoie |
|---|---|
mz reports list |
Tous les rapports publiés, du plus récent au plus ancien : son nom, version, date et auteur de publication, et les fichiers JSON qu’il contient |
mz reports read --slug <slug> |
Le HTML complet d’un rapport, et son enregistrement |
mz reports attachments --slug <slug> |
Les fichiers JSON qu’un rapport contient, chacun avec sa taille et le schéma qu’il nomme |
mz reports attachment --slug <slug> --name <file> |
Un fichier JSON seul, en données, sans le rapport autour |
Le <slug> d’un rapport se trouve dans mz reports list. mz reports read, mz reports attachments et mz reports attachment acceptent --version pour lire une version antérieure d’un rapport ; chaque version conserve ses propres fichiers. Pour sauvegarder un fichier, envoyez sa réponse dans un fichier : mz reports attachment --slug <slug> --name <file> > <file> (sur Windows, en invite de commandes).
Un nom non porté par le rapport est refusé, en indiquant ceux qui existent. Un fichier non valide JSON est refusé plutôt que renvoyé en texte, et le refus précise que le rapport doit être republié avec un fichier valide.
mz <group> --help montre les options exactes de chaque commande.
Les jobs s’exécutent un à un
Un projet exécute un job à la fois. Un job script lancé pendant que la carte Graphe de contexte de processus tourne attend que la carte ait terminé — sur un gros journal, cela peut prendre la majeure partie d’une heure — puis il ne dure que quelques secondes.
Suite
- Connect Your Own Agent – l’outil, la clé, et la phrase unique qui connecte votre agent.
- Obtenir le graphe de contexte du processus – le graphe par défaut, et comment l’obtenir en un seul appel.
- La boîte à outils du Cube – ce qu’un script comme celui-ci peut appeler.