Tus propios informes y JSON
El grafo del contexto del proceso es un valor predeterminado: nosotros decidimos qué contiene, por lo que tú no tienes que hacer nada para obtenerlo. Todo lo que vaya más allá es tuyo. Un proyecto puede contener cualquier número de informes, cada uno con cualquier número de archivos JSON, con nombres y estructuras que elijas, y tu agente accede a ellos exactamente de la misma forma que accede al grafo predeterminado.
Hay dos formas de crear uno:
- Con un script. Tú, o tu propio agente, escribís un breve script en Python que lee el log del proyecto y escribe un informe. No se usa IA.
- En palabras simples. Describe el informe en tus propias palabras, nombra los archivos JSON que quieras, y la IA escribe el informe y los archivos.
De cualquier forma, el resultado es lo mismo: un informe publicado en la pantalla de Informes (Reports), con archivos JSON nombrados por ti, junto al grafo predeterminado y no dentro de él. Los dos ejemplos siguientes se ejecutaron sobre el mismo proyecto real de compra-a-pago, con 1.6 millones de eventos, y los archivos que muestran son los que produjeron. Cómo tu agente obtiene su herramienta y su clave está en Conectar tu propio agente.
La única regla: ponle a tu JSON un nombre propio
Un archivo JSON que diga "schema": "mindzie.process-context-graph" se ajusta a nuestra definición cuando su informe es publicado, y un archivo que no tiene esa estructura impide que el informe se publique. Un archivo con cualquier otro nombre de esquema, o ninguno, nunca se verifica contra el nuestro: su forma es la que tú determines.
Así que una extensión no toma prestado nuestro nombre, ni añade campos al grafo predeterminado. Pon lo que añadas en un archivo propio, con un nombre propio — en el ejemplo siguiente usa partner.invoice-timing — y, cuando convenga, refiérete a los ids del grafo predeterminado (act:clear-invoice, el id de una arista, el id de una decisión) para que ambos se vinculen.
Con un script
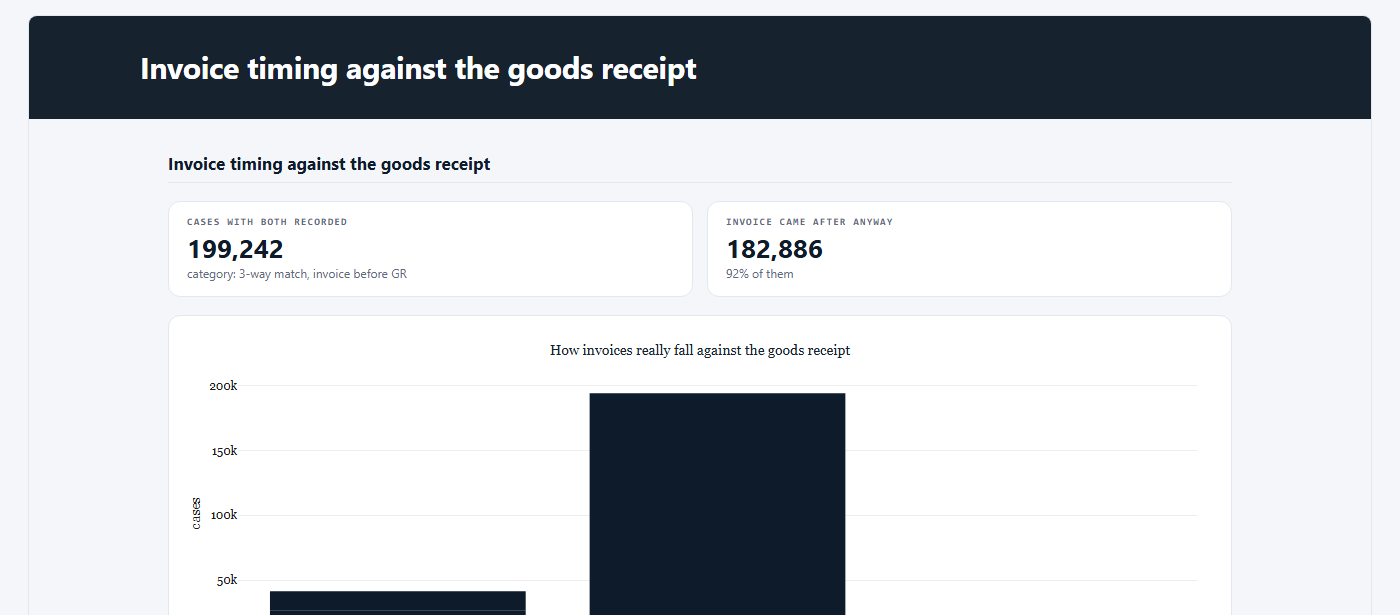
La pregunta: en la categoría de artículo "3-way match, invoice before GR" (conciliación de tres vías, factura antes de la recepción), ¿la factura realmente llega antes que la recepción de mercancías? Este script consulta el log y escribe un informe con dos archivos JSON de nombre propio. mzreport.json_download_link(name, document) escribe el enlace por el que se descarga un archivo JSON: cualquier nombre, cualquier JSON, tantos archivos como necesite el informe.
"""Invoice timing against the goods receipt - our own report, carrying our own JSON files."""
import sys
from pathlib import Path

import mindzie_engine as me
import mzreport
from mzlog import open_project
from mzreport import write_report

# A job run passes the path it wants as sys.argv[1]; mz run passes nothing.
OUT = Path(sys.argv[1]) if len(sys.argv) > 1 else Path("preview.html")
print("writing report to %s" % OUT)

SQL = """
WITH per_case AS (
    SELECT case_id,
           min(CASE WHEN activity = 'Record Goods Receipt' THEN timestamp END) AS goods_receipt,
           min(CASE WHEN activity = 'Record Invoice Receipt' THEN timestamp END) AS invoice,
           max("Item Category") AS category
    FROM events GROUP BY case_id)
SELECT category,
       CASE WHEN goods_receipt IS NULL OR invoice IS NULL THEN 'not both recorded'
            WHEN invoice < goods_receipt THEN 'invoice before goods receipt'
            ELSE 'invoice after goods receipt' END AS timing,
       count(*) AS cases,
       round(median(date_diff('day', goods_receipt, invoice)), 1) AS median_days_receipt_to_invoice
FROM per_case GROUP BY 1, 2 ORDER BY 1, 2
"""

project = open_project()
with project.log.session() as log:
    frame = log.query(SQL)

rows = []
for record in frame.to_dict("records"):
    days = record["median_days_receipt_to_invoice"]
    rows.append({"category": record["category"], "timing": record["timing"],
                 "cases": int(record["cases"]),
                 "median_days_receipt_to_invoice": None if days != days else float(days)})

before_gr = [row for row in rows if row["category"] == "3-way match, invoice before GR"]
both = [row for row in before_gr if row["timing"] != "not both recorded"]
after_anyway = sum(row["cases"] for row in both if row["timing"] == "invoice after goods receipt")
total_both = sum(row["cases"] for row in both)
kpis = {
    "schema": "partner.invoice-timing-kpis",
    "schema_version": "1",
    "category": "3-way match, invoice before GR",
    "cases_with_both_recorded": total_both,
    "invoice_after_goods_receipt_anyway": after_anyway,
    "share_after_anyway": round(after_anyway / total_both, 4) if total_both else None,
}

sections = [
    me.heading("Invoice timing against the goods receipt"),
    me.kpis([
        me.kpi("Cases with both recorded", "{:,}".format(total_both),
               sub="category: 3-way match, invoice before GR"),
        me.kpi("Invoice came after anyway", "{:,}".format(after_anyway),
               sub="{:.0%} of them".format(kpis["share_after_anyway"] or 0)),
    ]),
    me.chart_bar(frame, x="timing", y="cases",
                 title="How invoices really fall against the goods receipt"),
    me.prose("This report is our own analysis, not one of the shipped cards. It carries two "
             "JSON files of our own naming for any program to fetch: "
             + mzreport.json_download_link("invoice-timing.json",
                                           {"schema": "partner.invoice-timing",
                                            "schema_version": "1", "rows": rows})
             + " and "
             + mzreport.json_download_link("invoice-timing-kpis.json", kpis)
             + "."),
]
write_report(OUT, meta={"title": "Invoice timing against the goods receipt"}, sections=sections)
print("wrote %s" % OUT.name)
Los nombres de columna en la consulta son propios de este log; mz log schema dice cómo se llaman las columnas de tu log, y mz log activities qué nombres tienen los pasos. Luego:
mz run invoice_timing.py
mz jobs create --name "Invoice timing against the goods receipt"
mz jobs put-file --slug invoice-timing-against-the-goods-receipt --name invoice_timing.py --file invoice_timing.py
mz jobs run --slug invoice-timing-against-the-goods-receipt
mz jobs status --slug invoice-timing-against-the-goods-receipt
mz jobs outputs --slug invoice-timing-against-the-goods-receipt
mz jobs publish --slug invoice-timing-against-the-goods-receipt --run-id r0001 --output invoice_timing.html --name "Invoice timing against the goods receipt"
mz runejecuta el script una vez en el proyecto y muestra cualquier error completo: primero haz que corra limpio allí. Escribe una vista previa; la ejecución como trabajo (job run) es la que cuenta.mz jobs createresponde con el slug del trabajo, que las demás órdenes usan.mz jobs runlo ejecuta como trabajo. Tardó menos de 10 segundos.mz jobs outputsnombra la ejecución y el informe que escribió, ymz jobs publishpone ese informe en la pantalla Informes.
El informe lleva dos archivos, y mz reports attachments --slug invoice-timing-against-the-goods-receipt los lista:
| Nombre | Bytes | Esquema |
|---|---|---|
invoice-timing.json |
1,254 | partner.invoice-timing 1 |
invoice-timing-kpis.json |
236 | partner.invoice-timing-kpis 1 |
mz reports attachment --slug invoice-timing-against-the-goods-receipt --name invoice-timing-kpis.json devuelve el segundo, y la respuesta a la pregunta es no: en el 92 por ciento de esos artículos la factura se registró después de la recepción de mercancías.
{
  "schema": "partner.invoice-timing-kpis",
  "schema_version": "1",
  "category": "3-way match, invoice before GR",
  "cases_with_both_recorded": 199242,
  "invoice_after_goods_receipt_anyway": 182886,
  "share_after_anyway": 0.9179
}
En palabras simples
Sin script: tu agente describe el informe con sus propias palabras y nombra los archivos que quiere. Este es el brief que se envió, palabra por palabra:
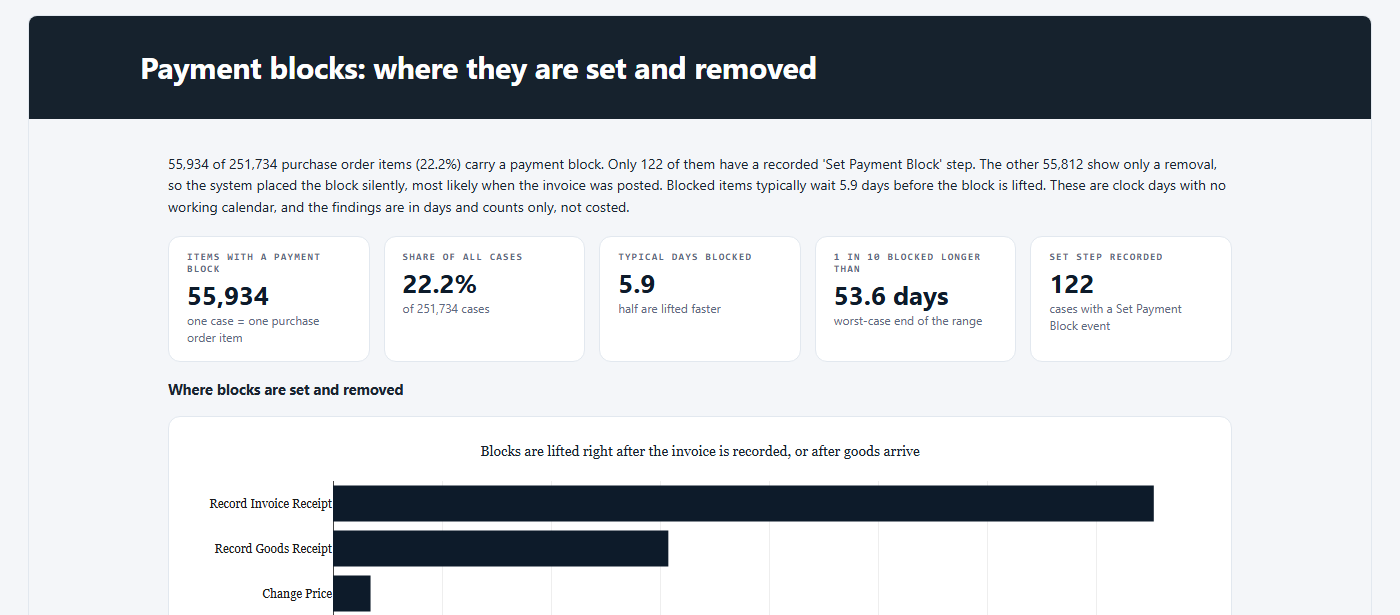
mz jobs create-agent --name "Payment blocks - where they are set and removed" --brief "Find where payment blocks are set and removed in this purchase-to-pay process: how many cases get a payment block, at which step it is set, how long it stays before it is removed, and which item categories and vendors are most affected. Keep it short. At the end of the report, attach two JSON files for a program to read, using mzreport.json_download_link inside a prose section: 'payment-blocks-summary.json' holding the headline numbers (cases blocked, share of all cases, median days blocked) and 'payment-blocks-by-category.json' holding one row per item category with cases blocked and median days blocked."
mz jobs run --slug payment-blocks-where-they-are-set-and-removed
mz jobs status --slug payment-blocks-where-they-are-set-and-removed
Este es un trabajo con IA: usa los créditos de IA de tu proyecto. Tomó 8 minutos, y el informe se publicó solo cuando la ejecución terminó, llevando exactamente los dos archivos solicitados. Una persona puede pedir el mismo informe desde la pantalla Informes del proyecto, en el cuadro debajo de las tarjetas (ver Informes).
payment-blocks-summary.json, tal como lo devolvió mz reports attachment:
{
  "basis": "Cases with at least one Set Payment Block or Remove Payment Block event; one case is one purchase order item. Days are clock days.",
  "cases_total": 251734,
  "cases_blocked": 55934,
  "share_of_all_cases_percent": 22.22,
  "median_days_blocked": 5.92,
  "median_days_blocked_basis": "block start is the recorded Set Payment Block, or the last Record Invoice Receipt before the removal when no set was recorded",
  "cases_with_recorded_set": 122,
  "median_days_blocked_recorded_set_only": 15.01,
  "cases_with_recorded_set_and_removal": 13
}
La IA eligió la forma de estos archivos, y no nombran esquema. Si tu programa necesita una forma fija, descríbela en el brief — los campos, sus nombres y un nombre de "schema" propio — o usa un script, donde la forma es exactamente la que escribas.
Cómo acceder a tus informes y JSON
Las mismas cuatro órdenes acceden al grafo predeterminado, a tus propios informes y a cualquier cosa que alguien más haya publicado en el proyecto:
| Comando | Qué devuelve |
|---|---|
mz reports list |
Todos los informes publicados, del más nuevo al más antiguo: su nombre, versión, cuándo y por quién se publicó, y los archivos JSON que lleva |
mz reports read --slug <slug> |
El HTML completo de un informe, y su registro |
mz reports attachments --slug <slug> |
Los archivos JSON que lleva un informe, cada uno con su tamaño y el esquema que nombra |
mz reports attachment --slug <slug> --name <file> |
Un archivo JSON, como dato, sin el informe alrededor |
El <slug> de un informe está en mz reports list. mz reports read, mz reports attachments y mz reports attachment aceptan --version para leer una versión anterior de un informe; cada versión conserva sus propios archivos. Para guardar un archivo, envía la respuesta a ese archivo: mz reports attachment --slug <slug> --name <file> > <file> (en Windows, en Símbolo del sistema).
Un nombre que el informe no lleve es rechazado, nombrando los que sí. Un archivo que no es JSON válido se rechaza en lugar de entregarse como texto, y el rechazo indica que el informe debe publicarse de nuevo con un archivo válido.
mz <group> --help muestra las opciones exactas de cada comando.
Los trabajos se ejecutan uno a la vez
Un proyecto ejecuta un trabajo a la vez. Un trabajo con script que se inicie mientras está corriendo la tarjeta del Grafo del Contexto del Proceso espera a que la tarjeta termine — en un log grande, eso puede ser casi una hora — y solo entonces toma sus pocos segundos.
Próximos pasos
- Conectar tu propio agente - la herramienta, la clave y la frase que conecta tu agente.
- Obtener el grafo del contexto del proceso - el valor predeterminado y cómo obtenerlo con una llamada.
- La caja de herramientas del Cube - qué puede llamar un script como el anterior.