Eigene Berichte und JSON
Der Process-Context-Graph ist eine Standardeinstellung: Wir haben entschieden, was darin enthalten ist, sodass Sie nichts unternehmen müssen, um ihn zu erhalten. Alles darüber hinaus gehört Ihnen. Ein Projekt kann beliebig viele Berichte enthalten, die jeweils beliebig viele JSON-Dateien mit von Ihnen gewählten Namen und Strukturen tragen – und Ihr Agent greift darauf genauso zu wie auf den Standardgraphen.
Es gibt zwei Möglichkeiten, einen solchen Bericht zu erstellen:
- Mit einem Skript. Sie oder Ihr eigener Agent schreiben ein kurzes Python-Skript, das das Log im Projekt liest und einen Bericht erstellt. Keine KI ist dabei beteiligt.
- In klaren Worten. Beschreiben Sie den Bericht mit eigenen Worten, benennen Sie die gewünschten JSON-Dateien, und die KI erstellt den Bericht und die Dateien.
In beiden Fällen ist das Ergebnis dasselbe: ein veröffentlichter Bericht auf dem Bildschirm Berichte, der JSON-Dateien mit von Ihnen gewählten Namen enthält, neben dem Standardgraphen, aber nicht innerhalb dieses. Beide unten gezeigten Beispiele wurden im selben realen Purchase-to-Pay-Projekt mit 1,6 Millionen Ereignissen ausgeführt, und die gezeigten Dateien sind die von ihnen erzeugten. Wie Ihr Agent sein Tool und seinen Schlüssel erhält, erfahren Sie unter Connect Your Own Agent.
Die eine Regel: Geben Sie Ihrem JSON einen eigenen Namen
Eine JSON-Datei, die "schema": "mindzie.process-context-graph" angibt, wird beim Veröffentlichen ihres Berichts an unsere Definition gebunden, und eine Datei, die diese Struktur nicht hat, verhindert die Veröffentlichung des Berichts. Eine Datei mit einem anderen Schema-Namen oder ohne einen solchen wird niemals mit unserem abgeglichen – ihre Struktur ist genau die von Ihnen festgelegte.
Eine Erweiterung übernimmt also nicht unseren Namen und fügt dem Standardgraphen keine Felder hinzu. Legen Sie das, was Sie ergänzen, in einer eigenen Datei mit eigenem Namen ab – das Beispiel unten verwendet partner.invoice-timing – und verweisen Sie, wo es hilfreich ist, auf die IDs des Standardgraphen (act:clear-invoice, die ID einer Kante, die ID einer Entscheidung), damit sich die beiden verbinden.
Mit einem Skript
Die Frage: Kommt in der Position mit der Artikelkategorie „3-way match, invoice before GR“ die Rechnung wirklich vor dem Wareneingang? Dieses Skript fragt das Log ab und erstellt einen Bericht mit zwei JSON-Dateien eigener Benennung. mzreport.json_download_link(name, document) erzeugt den Link, unter dem eine JSON-Datei bereitsteht – beliebiger Name, beliebiges JSON, so viele Dateien, wie der Bericht benötigt.
"""Rechnungs-Timing gegenüber dem Wareneingang – unser eigener Bericht mit eigenen JSON-Dateien."""
import sys
from pathlib import Path

import mindzie_engine as me
import mzreport
from mzlog import open_project
from mzreport import write_report

# Ein Joblauf erhält den Pfad als sys.argv[1]; mz run übergibt nichts.
OUT = Path(sys.argv[1]) if len(sys.argv) > 1 else Path("preview.html")
print("schreibe Bericht nach %s" % OUT)

SQL = """
WITH per_case AS (
    SELECT case_id,
           min(CASE WHEN activity = 'Record Goods Receipt' THEN timestamp END) AS goods_receipt,
           min(CASE WHEN activity = 'Record Invoice Receipt' THEN timestamp END) AS invoice,
           max("Item Category") AS category
    FROM events GROUP BY case_id)
SELECT category,
       CASE WHEN goods_receipt IS NULL OR invoice IS NULL THEN 'nicht beide aufgezeichnet'
            WHEN invoice < goods_receipt THEN 'Rechnung vor Wareneingang'
            ELSE 'Rechnung nach Wareneingang' END AS timing,
       count(*) AS cases,
       round(median(date_diff('day', goods_receipt, invoice)), 1) AS median_days_receipt_to_invoice
FROM per_case GROUP BY 1, 2 ORDER BY 1, 2
"""

project = open_project()
with project.log.session() as log:
    frame = log.query(SQL)

rows = []
for record in frame.to_dict("records"):
    days = record["median_days_receipt_to_invoice"]
    rows.append({"category": record["category"], "timing": record["timing"],
                 "cases": int(record["cases"]),
                 "median_days_receipt_to_invoice": None if days != days else float(days)})

before_gr = [row for row in rows if row["category"] == "3-way match, invoice before GR"]
both = [row for row in before_gr if row["timing"] != "nicht beide aufgezeichnet"]
after_anyway = sum(row["cases"] for row in both if row["timing"] == "Rechnung nach Wareneingang")
total_both = sum(row["cases"] for row in both)
kpis = {
    "schema": "partner.invoice-timing-kpis",
    "schema_version": "1",
    "category": "3-way match, invoice before GR",
    "cases_with_both_recorded": total_both,
    "invoice_after_goods_receipt_anyway": after_anyway,
    "share_after_anyway": round(after_anyway / total_both, 4) if total_both else None,
}

sections = [
    me.heading("Rechnungs-Timing gegenüber dem Wareneingang"),
    me.kpis([
        me.kpi("Fälle mit beiden aufgezeichnet", "{:,}".format(total_both),
               sub="Kategorie: 3-way match, invoice before GR"),
        me.kpi("Rechnung kam trotzdem danach", "{:,}".format(after_anyway),
               sub="{:.0%} davon".format(kpis["share_after_anyway"] or 0)),
    ]),
    me.chart_bar(frame, x="timing", y="cases",
                 title="Wie Rechnungen wirklich zum Wareneingang liegen"),
    me.prose("Dieser Bericht ist unsere eigene Analyse, nicht eine der mitgelieferten Karten. Er enthält zwei "
             "JSON-Dateien mit eigenen Namen für Programme zum Abruf: "
             + mzreport.json_download_link("invoice-timing.json",
                                           {"schema": "partner.invoice-timing",
                                            "schema_version": "1", "rows": rows})
             + " und "
             + mzreport.json_download_link("invoice-timing-kpis.json", kpis)
             + "."),
]
write_report(OUT, meta={"title": "Rechnungs-Timing gegenüber dem Wareneingang"}, sections=sections)
print("schrieb %s" % OUT.name)
Die Spaltennamen in der Abfrage gehören zum Log; mz log schema zeigt, wie Ihre Logspalten heißen, und mz log activities, wie dessen Schritte genannt sind. Dann:
mz run invoice_timing.py
mz jobs create --name "Rechnungs-Timing gegenüber dem Wareneingang"
mz jobs put-file --slug invoice-timing-against-the-goods-receipt --name invoice_timing.py --file invoice_timing.py
mz jobs run --slug invoice-timing-against-the-goods-receipt
mz jobs status --slug invoice-timing-against-the-goods-receipt
mz jobs outputs --slug invoice-timing-against-the-goods-receipt
mz jobs publish --slug invoice-timing-against-the-goods-receipt --run-id r0001 --output invoice_timing.html --name "Rechnungs-Timing gegenüber dem Wareneingang"
mz runführt das Skript einmal im Projekt aus und zeigt alle Fehler vollständig – lassen Sie es dort zunächst fehlerfrei laufen. Es schreibt eine Vorschau; der Joblauf ist entscheidend.mz jobs createlegt den Slug für den Job fest, den die anderen Befehle verwenden.mz jobs runführt den Job aus. Er brauchte weniger als 10 Sekunden.mz jobs outputszeigt den Lauf und den erstellten Bericht an, undmz jobs publishbringt diesen Bericht auf den Bildschirm Berichte.
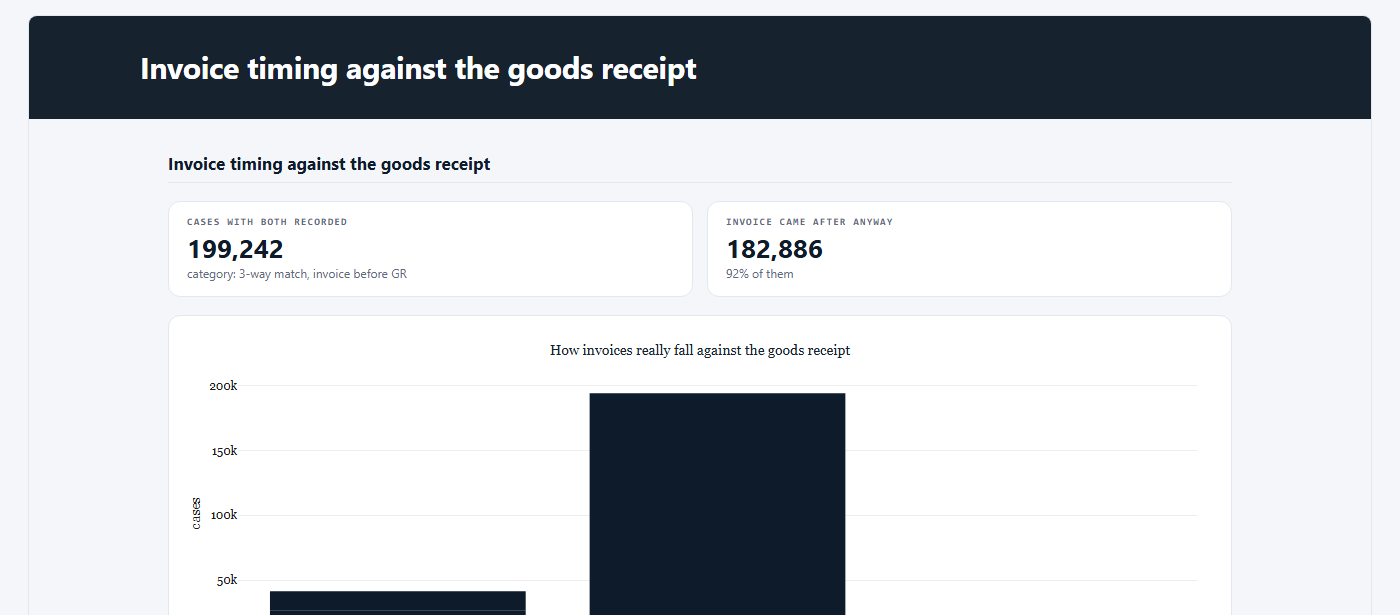
Der Bericht enthält zwei Dateien, und mz reports attachments --slug invoice-timing-against-the-goods-receipt listet sie auf:
| Name | Bytes | Schema |
|---|---|---|
invoice-timing.json |
1.254 | partner.invoice-timing 1 |
invoice-timing-kpis.json |
236 | partner.invoice-timing-kpis 1 |
mz reports attachment --slug invoice-timing-against-the-goods-receipt --name invoice-timing-kpis.json gibt die zweite Datei zurück – und die Antwort auf die Frage lautet nein: Bei 92 Prozent dieser Positionen wurde die Rechnung nach dem Wareneingang erfasst.
{
  "schema": "partner.invoice-timing-kpis",
  "schema_version": "1",
  "category": "3-way match, invoice before GR",
  "cases_with_both_recorded": 199242,
  "invoice_after_goods_receipt_anyway": 182886,
  "share_after_anyway": 0.9179
}
In klaren Worten
Kein Skript: Ihr Agent beschreibt den Bericht in eigenen Worten und benennt die gewünschten Dateien. Dies war das Wort-für-Wort-Briefing:
mz jobs create-agent --name "Payment blocks - where they are set and removed" --brief "Finden Sie heraus, wo in diesem Purchase-to-Pay-Prozess Zahlungssperren gesetzt und aufgehoben werden: wie viele Fälle eine Zahlungssperre erhalten, an welchem Schritt sie gesetzt wird, wie lange sie bleibt, bevor sie aufgehoben wird, und welche Artikelkategorien und Lieferanten am meisten betroffen sind. Halten Sie es kurz. Am Ende des Berichts fügen Sie zwei JSON-Dateien zum Programm-Abruf bei, verwenden Sie mzreport.json_download_link in einem Prose-Abschnitt: 'payment-blocks-summary.json' mit den Hauptzahlen (Fälle blockiert, Anteil aller Fälle, mediane Tage blockiert) und 'payment-blocks-by-category.json' mit je einer Zeile pro Artikelkategorie mit blockierten Fällen und medianen Tagen blockiert."
mz jobs run --slug payment-blocks-where-they-are-set-and-removed
mz jobs status --slug payment-blocks-where-they-are-set-and-removed
Dies ist ein KI-Job: Er nimmt AI-Credits Ihres Projekts in Anspruch. Die Ausführung dauerte 8 Minuten, und der Bericht veröffentlichte sich automatisch nach Beendigung, mit genau den zwei angeforderten Dateien. Ein Nutzer kann dieselbe Abfrage auch im Projekt auf dem Bildschirm Berichte stellen, im Feld unter den Karten (siehe Berichte).
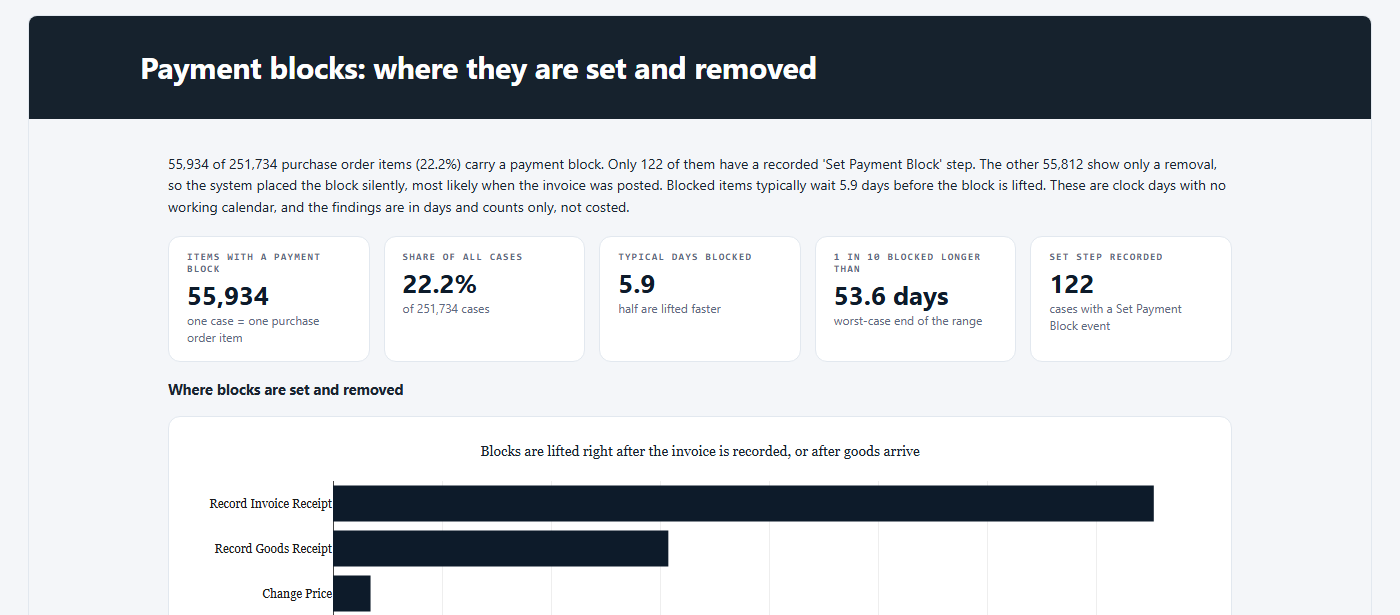
payment-blocks-summary.json, wie mz reports attachment es zurückgab:
{
  "basis": "Fälle mit mindestens einem Ereignis Set Payment Block oder Remove Payment Block; ein Fall ist eine Bestellposition. Tage sind Kalendertage.",
  "cases_total": 251734,
  "cases_blocked": 55934,
  "share_of_all_cases_percent": 22.22,
  "median_days_blocked": 5.92,
  "median_days_blocked_basis": "Blockbeginn ist das aufgezeichnete Set Payment Block oder der letzte Record Invoice Receipt vor der Aufhebung, wenn kein Set aufgezeichnet wurde",
  "cases_with_recorded_set": 122,
  "median_days_blocked_recorded_set_only": 15.01,
  "cases_with_recorded_set_and_removal": 13
}
Die KI wählte die Struktur dieser Dateien, und sie nennen kein Schema. Wenn Ihr Programm eine feste Struktur benötigt, beschreiben Sie diese im Brief – die Felder, ihre Namen und einen eigenen "schema"-Namen – oder verwenden Sie ein Skript, in dem die Struktur genau das ist, was Sie schreiben.
Zugriff auf Ihre Berichte und JSON
Mit denselben vier Befehlen greifen Sie auf den Standardgraphen, Ihre eigenen Berichte und alles, was jemand sonst im Projekt veröffentlicht hat, zu:
| Befehl | Was er zurückgibt |
|---|---|
mz reports list |
Alle veröffentlichten Berichte, neueste zuerst: Name, Version, wann und von wem veröffentlicht, und die JSON-Dateien, die sie tragen |
mz reports read --slug <slug> |
Den kompletten HTML-Bericht und seinen Datensatz |
mz reports attachments --slug <slug> |
Die JSON-Dateien, die ein Bericht enthält, jeweils mit Größe und genanntem Schema |
mz reports attachment --slug <slug> --name <file> |
Eine einzelne JSON-Datei, als Daten, ohne den Bericht drumherum |
Der <slug> eines Berichts steht in mz reports list. mz reports read, mz reports attachments und mz reports attachment akzeptieren --version, um eine frühere Version eines Berichts zu lesen; jede Version behält ihre eigenen Dateien. Um eine Datei zu speichern, leiten Sie die Antwort weiter: mz reports attachment --slug <slug> --name <file> > <file> (unter Windows im Command Prompt).
Ein nicht im Bericht enthaltener Name wird abgelehnt, die enthaltenen werden genannt. Eine Datei, die kein gültiges JSON ist, wird abgelehnt statt als Text ausgegeben, und die Ablehnung weist darauf hin, dass der Bericht mit einer gültigen Datei erneut veröffentlicht werden muss.
mz <group> --help zeigt die genauen Optionen jedes Befehls.
Jobs laufen nacheinander
Ein Projekt führt immer nur einen Job gleichzeitig aus. Ein Skriptjob, der gestartet wird, während die Karte des Process Context Graph läuft, wartet, bis die Karte fertig ist – bei einem großen Log kann das fast eine Stunde dauern – und benötigt dann nur wenige Sekunden.
Weiter
- Connect Your Own Agent – das Tool, der Schlüssel und der eine Satz, der Ihren Agenten verbindet.
- Den Process Context Graph erhalten – die Standardeinstellung und wie man sie mit einem Aufruf abruft.
- Die Toolbox des Cubes – was ein Skript wie das oben verwendete aufrufen kann.